- インデックス状況を正しく確認する方法
- 未登録ステータスごとの原因の読み方
- 設定ミスと内容面の原因の切り分け手順
- 未登録URLが溜まったサイトの立て直し方
記事を公開して数週間たっても、検索結果にまったく出てこない。Search Consoleを開くと「クロール済み - インデックス未登録」や「検出 - インデックス未登録」と表示されたURLが並んでいて、何から手を付ければよいのか分からない。インデックスの相談では、この状態から話が始まることがほとんどです。
インデックスされない原因は1つではありません。noindexの外し忘れのような設定ミスもあれば、ページの内容が他と重複しているためにGoogleが登録を見送っているケースもあります。原因の種類によって直し方がまったく違うので、思い当たる対策を片端から試しても、時間を使うわりに状況は変わりません。
インデックスされない原因は、Search Consoleが示すステータスから切り分けるのが最短です。ステータスごとに、Googleがどの段階で止めているのかが分かるからです。
この記事では、インデックス未登録の確認方法から、ステータス別の原因の読み方、技術面と内容面それぞれの原因、切り分けの手順までを順に説明します。最後に、未登録のURLが大量に溜まってしまったサイトを立て直すときの進め方も扱います。
インデックス未登録を正しく確認する方法
原因を探す前に、本当にインデックスされていないのかを確かめます。確認の手段を誤ると、登録済みのページを未登録と思い込んで直したり、反対に未登録を見落としたりします。
site:検索だけで判断しない理由
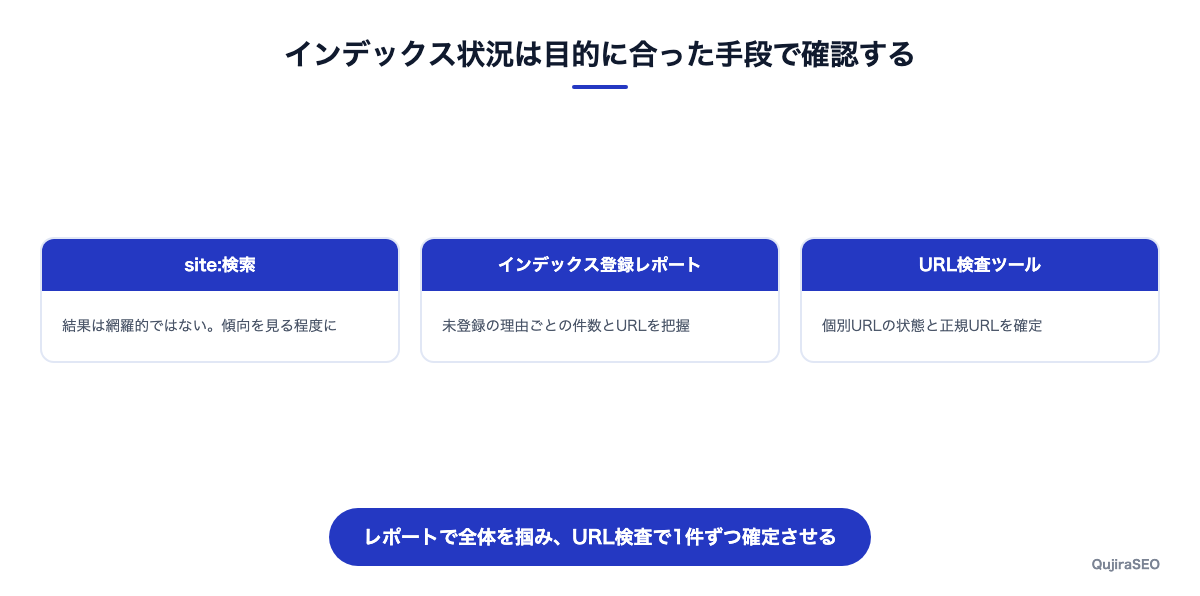
「site:ドメイン名」で検索して件数を見る方法はよく知られています。ただ、Googleは公式ドキュメントで「返される URL のリストは網羅的ではありません」と明記しています(https://developers.google.com/search/docs/monitor-debug/search-operators/all-search-site?hl=ja )。
site:検索で出てこないからといって、未登録とは限りません。表示された件数も概算として扱い、サイト全体の傾向を眺める程度に留めます。個別のURLの登録状況を確定させるには、次に説明する2つの機能を使います。
ページのインデックス登録レポートとURL検査の使い分け
Search Consoleの「ページのインデックス登録」レポートは、サイト全体のURLが登録済みか未登録か、未登録ならどの理由に当たるかを一覧で示します。どの種類の問題が何件あるかを掴む入口になります。
URL検査ツールは、1つのURLを詳しく調べる機能です。Googleのヘルプによれば、通常の検査結果は直近にインデックス登録されたバージョンの情報で、ライブテストを実行するとその時点のページをリアルタイムで取得して検査します(https://support.google.com/webmasters/answer/9012289?hl=ja )。
| 手段 | 分かること | 向いている場面 |
|---|---|---|
| site:検索 | 登録されているURLの一部 | 大まかな傾向を見る |
| ページのインデックス登録レポート | 未登録の理由ごとの件数とURL | サイト全体の問題を掴む |
| URL検査ツール | 個別URLの登録状況、正規URL、ライブの取得結果 | 原因を1件ずつ確定させる |
レポートで「どの理由が多いか」を掴み、代表的なURLをURL検査で深掘りする。この二段構えが確認の基本になります。
ステータスから読むインデックスされない原因
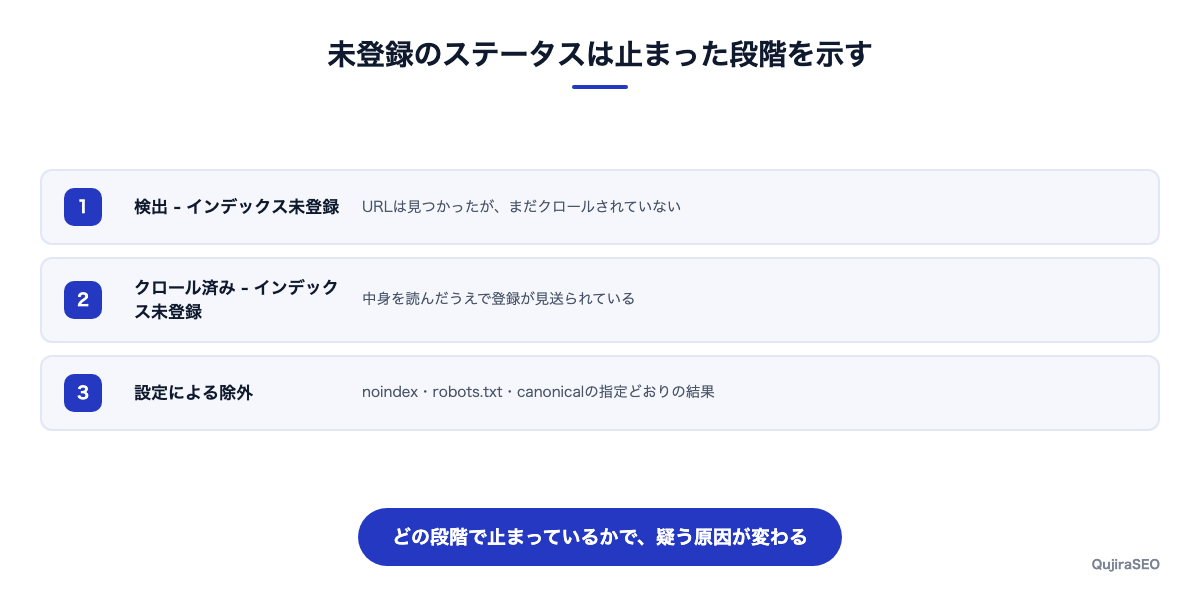
ページのインデックス登録レポートに出る未登録の理由は、Googleの処理のどの段階で止まっているかを表しています。ここを読み違えなければ、原因の候補は大きく絞れます。
検出 - インデックス未登録が示すもの
Googleのヘルプでは、このステータスを「ページを検出したもののまだクロールしていない」状態と説明しています。サイトへの過負荷が予想され、クロールが先送りされた場合に起きるとされています(https://support.google.com/webmasters/answer/7440203?hl=ja )。
つまり、Googleはまだページの中身を見ていません。この段階で本文をいくら書き直しても、読まれていない以上は判断材料になりません。疑うべきはサーバーの応答速度やエラー、クロールさせる必要の薄いURLが大量にあってクロールの順番が回ってこない状態です。
Googleのクロールバジェットのガイドでは、対象となるサイトの例として「Search Console で URL の大部分が検出- インデックス未登録に分類されるサイト」が挙げられています(https://developers.google.com/search/docs/crawling-indexing/large-site-managing-crawl-budget?hl=ja )。このステータスの割合が高いほど、クロールの効率に問題がある可能性が高いと読めます。
クロール済み - インデックス未登録が示すもの
こちらはGoogleがページを取得したうえで、登録を見送っている状態です。同じヘルプには、今後登録される可能性もあり、クロールを再リクエストする必要はないと書かれています。
ページは読まれているので、技術的に取得できないという問題ではありません。見直す対象は、ページの内容がサイト内外の他のページと重複していないか、検索ユーザーにとって独自の情報があるか、サイト内でそのページがどう位置付けられているか、といった内容と構造の側です。
設定どおりに除外されているステータス
レポートに出る未登録のURLには、サイトの設定によって意図的に除外されているものも含まれます。代表的なものを整理します。
| ステータス | 意味 | 対処の要否 |
|---|---|---|
| URL に noindex が指定されています | noindexを検出したため登録していない | 登録したいページなら設定を外す |
| URL が robots.txt によってブロックされています | クロールが禁止されている | 登録したいページなら許可する |
| 重複していますが、ユーザーが正規ページとして選択していません | Googleが別のURLを正規として選んだ | 正規URLの指定を見直す |
| 代替ページ(適切な canonical タグあり) | 正規ページの代替として扱われている | 原則不要 |
| ソフト 404 | 中身が無いのに404を返していない | 404を返すか中身を充実させる |
これらは設定の結果なので、まず「そのURLは登録させたいページか」を判断します。登録させたくないページであれば、未登録のままで問題ありません。Googleのヘルプも「サイトのすべての URL がインデックスに登録されるわけではありません」としています。
技術的な設定ミスによる原因
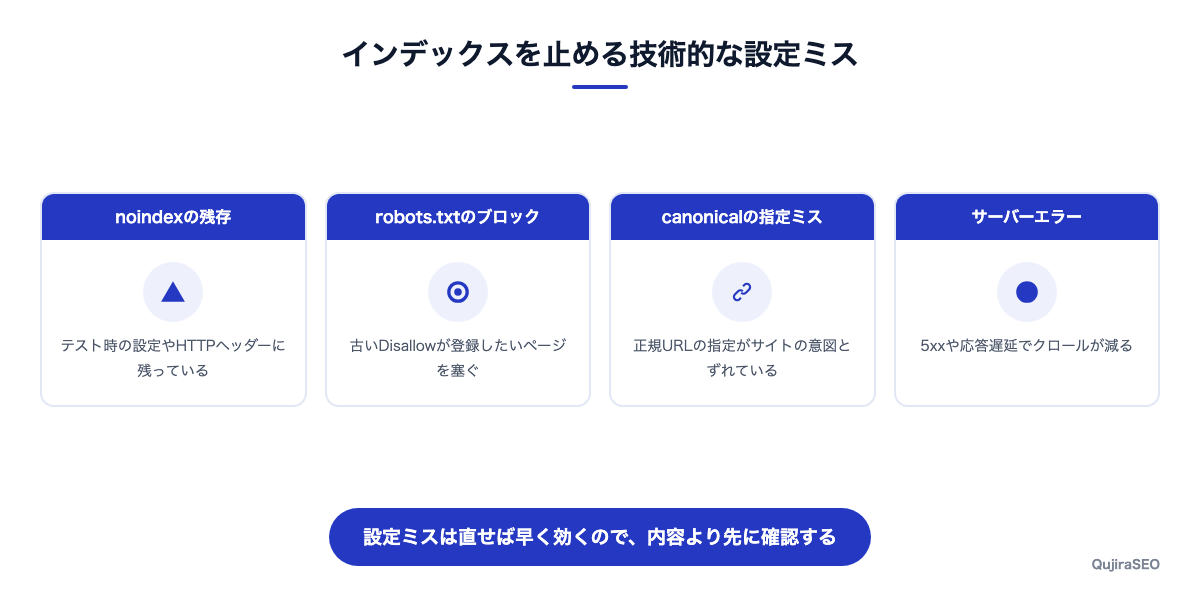
登録させたいページが設定によって除外されているなら、原因は技術的な設定ミスです。直せば効果が出るまでが早い領域なので、内容の見直しより先に確認します。
noindexの外し忘れ
公開前のテスト環境で付けたnoindexが本番に残ったまま、というケースは珍しくありません。CMSの「検索エンジンにインデックスさせない」設定、SEOプラグインの個別設定、テンプレートに直書きされたmetaタグ、HTTPヘッダーのX-Robots-Tagなど、noindexが入り込む場所は複数あります。
URL検査ツールで該当URLを調べると、noindexが検出されたかどうかが表示されます。ソースを見ても見当たらない場合は、HTTPヘッダー側で付与されていないかを確認します。
robots.txtによるブロック
robots.txtで特定のディレクトリをDisallowにした結果、登録させたいページまでクロールできなくなっていることがあります。サイトのリニューアルでディレクトリ構成が変わったのに、robots.txtだけ古い記述が残っている場合に起きやすい問題です。
注意したいのは、robots.txtはクロールを止める仕組みであって、インデックスを止める仕組みではない点です。Googleのヘルプでも、robots.txtでブロックしたURLが他の経路で登録されることがあるとしています。確実に検索結果から外したいページは、クロールを許可したうえでnoindexを使います。
注意したいこと
robots.txtでブロックしたページにnoindexを書いても、Googleはそのページを読めないためnoindexを認識できません。除外の目的で両方を同時に設定するのは逆効果です。
canonicalの指定ミスとリダイレクト
全ページのcanonicalがトップページを指している、パラメータ付きURLが正規として指定されている、といったテンプレートのミスがあると、本来登録させたいページが正規として扱われません。
Googleの重複URLの統合に関するドキュメントでは、正規URLを示す方法として、リダイレクトとrel="canonical"は強いシグナル、サイトマップへの掲載は弱いシグナルと説明されています(https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls?hl=ja )。canonical、内部リンク、サイトマップがそれぞれ違うURLを指していると、Googleがサイトの意図と異なるURLを正規に選ぶ原因になります。
サーバーエラーとソフト404
サーバーが5xxエラーを返していたり、応答が遅かったりすると、Googleはクロールを控えます。クロールバジェットのガイドでは、5xxエラーやHTTP 429が返された場合にクロールが減ると説明しています。
ソフト404は、在庫切れの商品ページや検索結果0件のページなど、中身が無いのにステータスコード200を返しているページで起きます。存在しないページは404や410を返し、残すページは中身を補います。
内容とサイト構造による原因
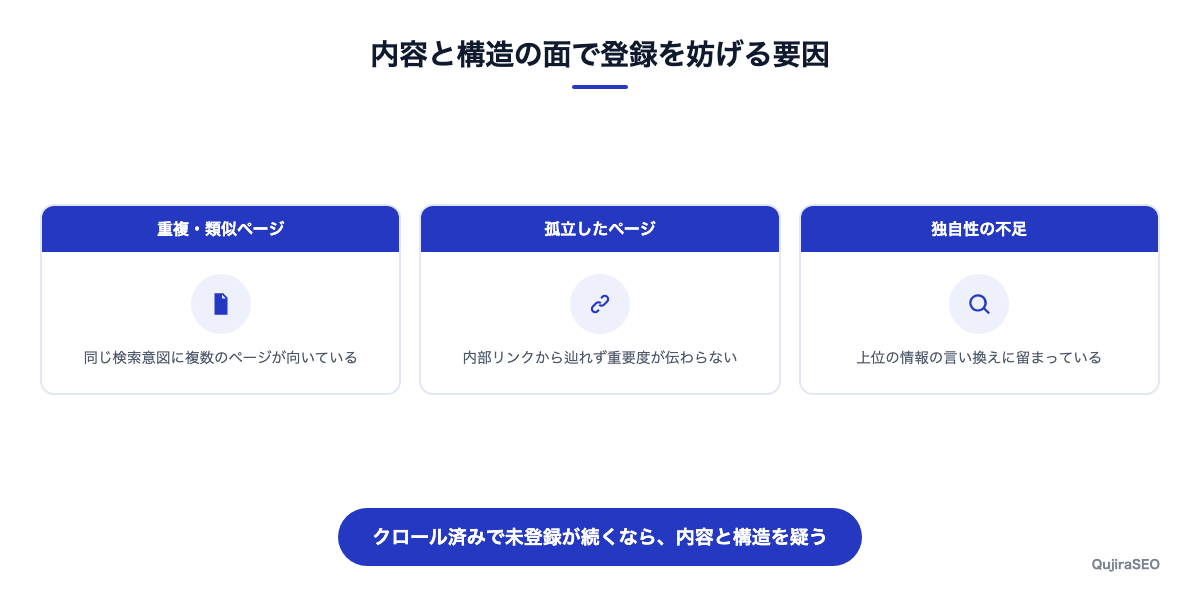
技術的な設定に問題が無いのに「クロール済み - インデックス未登録」が続くなら、原因は内容とサイト構造の側にあると考えます。直すのに時間がかかる領域ですが、ここを避けていると状況は変わりません。
重複や類似ページの多さ
同じテーマの記事を角度を変えて何本も書いていたり、地域名だけを差し替えたページを量産していたりすると、Googleはそれらを重複として扱い、1つを正規に選んで残りを登録しないことがあります。
サイト側から見れば別の記事でも、検索ユーザーに届ける情報がほぼ同じなら、Googleが複数を登録する理由は薄くなります。タイトルと見出しを並べて比べ、主張と情報が重なっている記事群を洗い出すのが第一歩です。
内部リンクから辿れないページ
公開後にどこからもリンクされていないページは、Googleがサイト内での重要度を判断しにくくなります。サイトマップに載っていても、サイト内の導線が無ければ優先して扱われにくい状態です。
カテゴリページや関連記事から内部リンクが張られているかを確認します。内部リンクの設計については、https://qujiraseo.com/blog/naibu-link-harikata/ で詳しく扱っています。
検索で拾う価値が薄いと判断されるページ
検索結果の上位にすでにある情報を言い換えただけの記事は、登録してもユーザーに新しい価値を届けにくいページです。一次情報、具体的な手順、比較の根拠など、そのページにしか無い要素が無いと、登録が見送られる理由になり得ます。
ここはGoogleが判断の基準を細かく公開していない領域なので、断定はできません。それでも、重複や内部リンクの問題を解消しても登録されないページは、内容そのものを見直す候補に入れます。
ここがポイント
内容の問題を疑うときは、1本ずつ手直しする前に、同じ症状のページを並べて共通点を探します。テーマが重なっている、文字数が極端に少ない、テンプレート部分が本文より長いなど、共通点が見つかれば打ち手をまとめて決められます。
インデックスされない原因を切り分ける手順
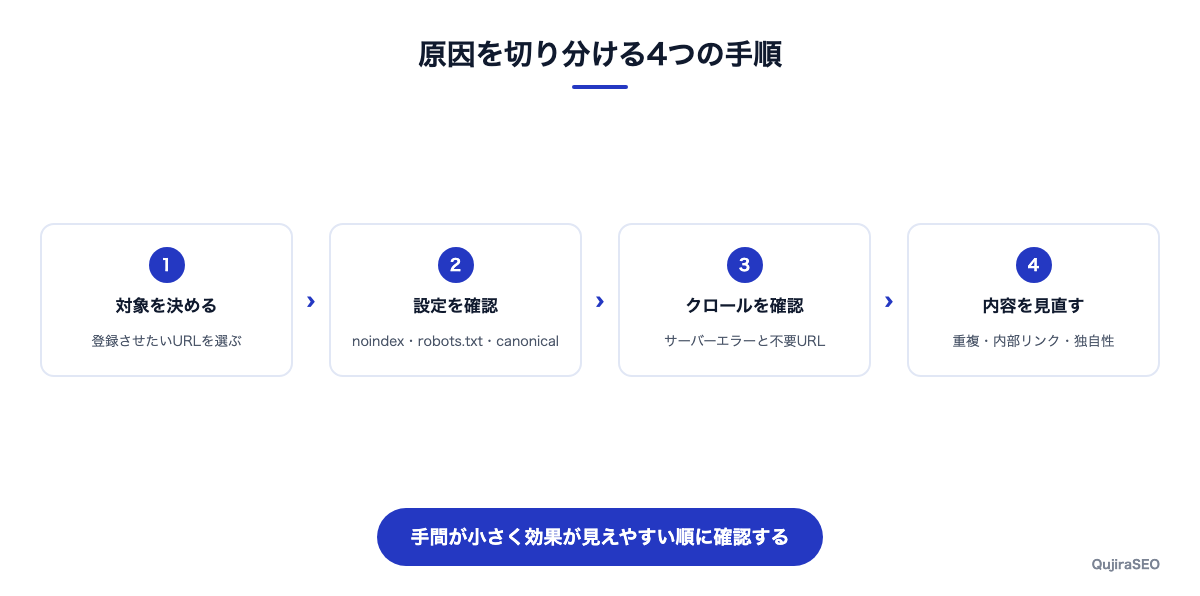
ここまでの内容を、実際に作業する順番に並べます。手間が小さく、直したときの効果が分かりやすいものから順に確認していくのが基本です。
手順1 登録させたいURLかを決める
最初に、未登録のURLのうち、本当に検索結果に出したいページはどれかを決めます。タグページ、パラメータ付きURL、印刷用ページ、社内向けのページなどは、未登録のままで構わないものです。
この仕分けをしないまま対処を始めると、登録させる必要の無いURLにまで手間をかけることになります。レポートの件数を減らすことが目的ではない点を最初に確認しておきます。
手順2 設定による除外を外す
登録させたいURLが、noindex、robots.txt、canonicalの指定によって除外されていないかを確認します。URL検査ツールで「インデックス登録が許可されているか」「Googleが選択した正規URL」を見れば、多くの場合ここで原因が特定できます。
設定を直したら、ページのインデックス登録レポートで「修正を検証」を実行します。Googleのヘルプでは、検証は通常2週間ほどで完了し、それより長くかかる場合もあるとされています。
手順3 クロールの妨げを取り除く
「検出 - インデックス未登録」が多い場合は、サーバーの応答とエラーを確認します。Search Consoleのクロールの統計情報で、応答時間やエラーの推移が見られます。
あわせて、クロールさせる必要の無いURLが大量に生成されていないかを見ます。絞り込み検索のパラメータやセッションIDで同じ内容のURLが増えていると、本当に登録させたいページにクロールが回りにくくなります。
手順4 内容と構造を見直す
設定にもクロールにも問題が無く「クロール済み - インデックス未登録」が残るページは、重複、内部リンク、内容の独自性を見直します。ここは1ページ単位ではなく、サイト全体の記事群を整理する作業になることが多いため、次の章で進め方を説明します。
| 手順 | 確認すること | 使う機能 |
|---|---|---|
| 1 | 登録させたいURLか | ページのインデックス登録レポート |
| 2 | noindex・robots.txt・canonical | URL検査ツール |
| 3 | サーバーエラー・不要URLの多さ | クロールの統計情報 |
| 4 | 重複・内部リンク・内容 | 記事一覧の棚卸し |
未登録が大量に溜まったサイトの立て直し方
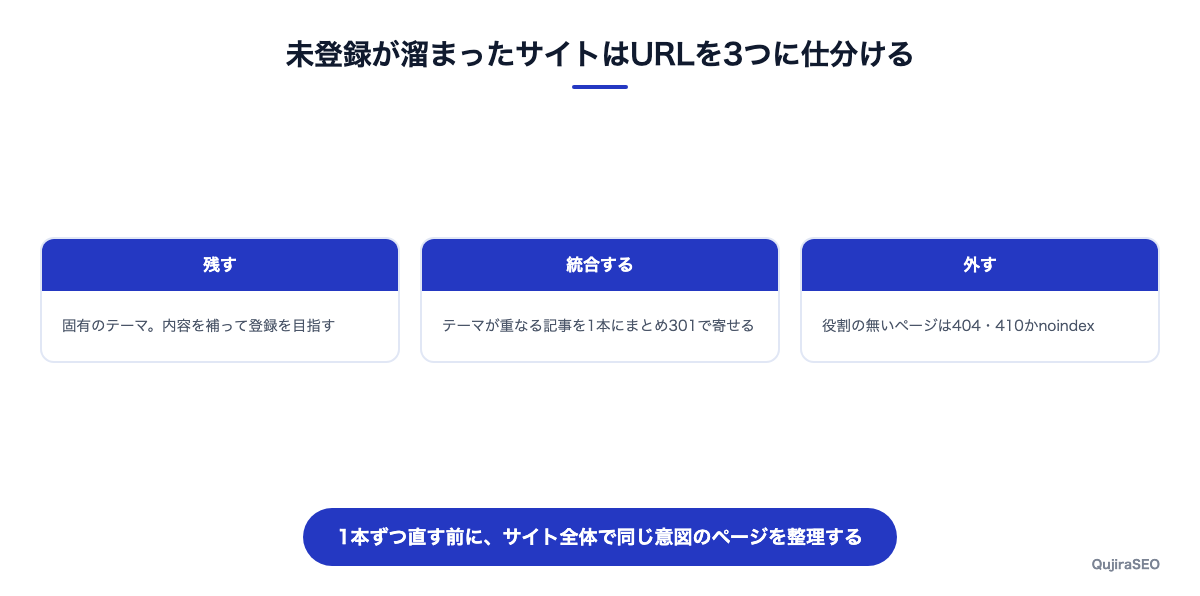
記事を量産してきたサイトや、運用担当が何度か替わったサイトでは、未登録のURLが登録済みより多くなっていることがあります。この状態で1本ずつリライトしても、作業量に対して改善が見えにくくなります。ここでは、サイト単位で状態を戻すときの進め方を説明します。
全URLを残す・統合する・外すに仕分ける
まず、未登録のURLも含めて記事を一覧にし、それぞれを3つに仕分けます。
- 残す: テーマが固有で、内容を補えば登録が見込めるページ
- 統合する: 他の記事とテーマが重なっていて、1本にまとめたほうが情報が厚くなるページ
- 外す: 検索から集客する役割が無く、残しておく理由が薄いページ
仕分けの基準は、ページ単体の出来ではなく、サイト全体で同じ検索意図に何本のページが向いているかです。同じ意図に3本向いているなら、1本に絞ったほうがGoogleにとってもユーザーにとっても分かりやすくなります。
統合と削除の進め方
統合する記事は、情報を残す側の記事に移し、統合元のURLから残す側へ301リダイレクトを設定します。リダイレクトは正規URLを示す強いシグナルなので、統合の意図がGoogleに伝わりやすくなります。
外すページは、内容が無くなったのであれば404か410を返します。社内向けなど公開自体は続けたいページはnoindexにします。どちらの場合も、サイトマップと内部リンクから外しておかないと、Googleに矛盾したシグナルを送ることになります。
修正後に確認する指標と期間
立て直しの効果は、未登録の件数が減ったかどうかだけでは測れません。不要なURLを外せば未登録の件数は減りますが、残したページが登録され、検索で表示されるようになったかが本来の目的です。
確認する指標は、ページのインデックス登録レポートの登録済み件数、残したページごとの表示回数、検索パフォーマンスでの合計の表示回数です。Googleのヘルプにあるとおり、インデックス登録やその検証には数日から数週間かかることがあるため、修正の直後に判断せず、数週間単位で推移を見ます。
注意したいこと
未登録のURLを一度に大量に削除すると、どの対処が効いたのか後から分からなくなります。統合と削除は、効果を確認できる単位に区切って進めます。
コンテンツの整理とあわせて記事を書き直す場合は、https://qujiraseo.com/blog/kiji-rewrite-kotsu/ も参考にしてください。
よくある質問
インデックス登録をリクエストすれば登録されますか
リクエストは、Googleにクロールを依頼する手段であって、登録を保証するものではありません。Googleのヘルプでも、送信できるリクエスト数には1日あたりの上限があるとされています。原因が残ったままリクエストを繰り返すより、原因を直してから一度送るほうが確実です。
公開してから何日くらいでインデックスされますか
決まった日数はありません。GoogleのURL検査ツールのヘルプにも、通常1日程度で済むという記述と、1〜2週間程度かかるという記述の両方があり、サイトやページによって幅があります。数週間たっても登録されない場合は、この記事の手順で原因を確認します。
未登録のページがあるとサイト全体の評価が下がりますか
未登録のURLがあること自体は、異常ではありません。Googleも、サイトのすべてのURLが登録されるわけではないとしています。問題になるのは、登録させたいページが登録されない状態や、不要なURLが大量にあって重要なページにクロールが回らない状態です。
サイトマップを送信すれば解決しますか
サイトマップはURLの存在をGoogleに伝える手段で、Googleのドキュメントでも正規URLを示すシグナルとしては弱いものとされています。「検出 - インデックス未登録」や「クロール済み - インデックス未登録」は、サイトマップを送っていても起きます。送信は前提として行い、そのうえでステータス別の原因を確認します。
まとめ
- インデックスの確認は、site:検索ではなく、ページのインデックス登録レポートとURL検査ツールで行う
- 「検出 - インデックス未登録」はクロール前、「クロール済み - インデックス未登録」はクロール後に登録を見送った状態で、疑う原因が異なる
- noindex、robots.txt、canonicalの設定ミスは効果が出るまでが早いので、最初に確認する
- 設定に問題が無ければ、重複、内部リンク、内容の独自性を見直す
- 未登録が大量に溜まったサイトは、全URLを残す・統合する・外すに仕分けてから手を入れる
インデックスされない原因は、ステータスを読めば候補を大きく絞れます。思い当たる対策を順に試すのではなく、Googleがどの段階で止めているかを確かめるところから始めてください。